На этой неделе: остановка бесполезных циклов, проверка действий, retrieval и эксплуатация агентных сессий. Главная связующая тема недели — измерять поведение всей системы, включая состояние, внешние эффекты и происхождение свидетельств.
Материалов по этому запросу нет. Измените запрос или сбросьте фильтры.
Исследования 12
Jiaqi Zhao и соавторы · HIT Shenzhen · 2026-10-05
HEAR: связать план агента с состоянием inference engine
backendcostagents
Двунаправленный протокол передаёт зависимости workflow и жизненный цикл контекста в serving engine, а состояние очереди и KV-cache возвращает оркестратору. Это полезная архитектурная идея для backend, который обслуживает несколько агентов одновременно: локальная оптимизация очереди может конфликтовать с приоритетами всей задачи.
Основание, ограничения и следующий шаг
Что показали / как устроено
Двунаправленный протокол передаёт зависимости workflow и жизненный цикл контекста в serving engine, а состояние очереди и KV-cache возвращает оркестратору.
Проверены конкретные политики и нагрузки SCBench, Mooncake, BrowseComp-Plus и DeepResearchBench. Выигрыш нельзя переносить на любой сервер; агрессивное повторное использование кеша может ухудшить ожидание холодных запросов.
Для моей работы
Мой вывод: хранить session ID, зависимости и срок ожидания рядом с запросом к модели. Сравнения авторов используют одинаковые модели, входы, бюджеты и оборудование внутри каждого эксперимента.
Следующий шаг
Измерить TTFT, хвост задержки и cache reuse под смешанной нагрузкой; сначала проверить защиту от голодания.
Han Luo и соавторы · UW / Leeds / CMU / Stanford / Ai2 · 2026-10-05
HERA: учить harness останавливаться на невыполнимых задачах
agentsevals
Авторы совместно развивают среду задач и управляющую оболочку агента. Из выполнимой задачи создаётся проверяемая невыполнимая версия, затем новые случаи строятся по прежним ошибкам. Читать стоит ради подхода к evals: отказ завершать невозможное действие нужно оценивать вместе с успехом на обычных задачах.
Основание, ограничения и следующий шаг
Что показали / как устроено
Авторы совместно развивают среду задач и управляющую оболочку агента.
Среды и мутации генерируются автоматически и проходят проверку другими агентами. Это не доказательство надёжной остановки в вашем production; остаётся зависимость от качества верификации пар.
Для моей работы
Мой вывод: набор негативных тестов должен эволюционировать вместе с harness. В отличие от фиксированного benchmark, новые мутации заставляют систему встречать ещё не закрытые причины отказа.
Следующий шаг
Добавить пары «доступный ресурс / удалённый ресурс» и отдельно считать ложные отказы и продолжение невыполнимой работы.
Shouju Wang, Haopeng Zhang · UNC Charlotte · 2026-10-05
AgentPrivArena: приватность по всей траектории
agentssecurityevals
Оценивать только финальный ответ недостаточно: агент мог без необходимости прочитать защищённые данные раньше. AgentPrivArena использует реальные MCP-интерфейсы и локальные сервисы, а AgentPrivAudit проверяет потоки информации на границах чтения и записи. Это даёт основу для аудита внутренних агентов с широким доступом.
Основание, ограничения и следующий шаг
Что показали / как устроено
Оценивать только финальный ответ недостаточно: агент мог без необходимости прочитать защищённые данные раньше.
Из сценариев PrivacyLens в исполняемые задачи удалось преобразовать только часть. Оценки зависят от моделей аудитора и судей, а доступ к информации и её утечка остаются разными метриками.
Для моей работы
Мой вывод: логировать минимально необходимые категории доступа, а не только выходной текст. Эксперимент сравнивает отсутствие защиты, privacy prompt и три политики одного механизма аудита на одинаковых задачах.
Следующий шаг
Разметить один workflow по минимально необходимым данным и проверить избыточное чтение до внешнего действия.
Zhongxiang Sun и соавторы · RUC / Kuaishou · 2026-10-05
EBG: показать, что агент действительно сделал
agentscodingevals
Evidence-Grounded Behavior Graph организует код и траекторию в доказательства, действия, области и связи. Затем монитор показывает пользователю существенные решения, которые легко скрываются в длинной сессии. Материал полезен для review: успешные тесты ещё не означают, что реализация соответствует исходному требованию.
Основание, ограничения и следующий шаг
Что показали / как устроено
Evidence-Grounded Behavior Graph организует код и траекторию в доказательства, действия, области и связи.
Построение графа использует только видимый контекст. Невидимые действия не появятся в доказательствах; семантические выводы монитора требуют своей проверки. Benchmark включает специально подготовленные отклонения и отложенную обратную связь.
Для моей работы
Мой вывод: у замечания в review должна быть ссылка на конкретную операцию или фрагмент кода. Граф строится детерминированно, но итоговую интерпретацию поведения делает модель.
Следующий шаг
Попробовать evidence ID в отчёте агента: требование → изменённый участок → проверка; оценить находки против обычного review.
Yaoqi Chen и соавторы · Microsoft / USTC / UCSD · 2026-10-05
PrisMem: улучшать память по отдельным способностям
agentsRAGevals
Общий score памяти может скрывать регрессии в отдельных способностях. PrisMem выбирает направления улучшения с учётом зависимостей, сохраняет полезные варианты и объединяет их по различающимся трассам. Читать стоит, если один механизм памяти должен одновременно находить факты, отслеживать изменения и собирать сведения между сессиями.
Основание, ограничения и следующий шаг
Что показали / как устроено
Общий score памяти может скрывать регрессии в отдельных способностях.
Основание
препринт; рецензирование не подтверждено. Подробнее: 4.1 Experimental Setup; C.2 Transfer Experiments; C.3 Capability Router Experiments.
Ограничение
Программы памяти эволюционируют на меньших benchmark и проверяются на более длинных историях. Результаты BEAM и LongMemEval не подтверждают качество на постоянно меняющихся корпоративных данных или соблюдение ACL.
Для моей работы
Мой вывод: разбить eval памяти на факты, время, предпочтения и синтез. Авторы сравнивают статические и самоизменяющиеся системы; отдельная маршрутизация между лучшими вариантами не заменяет их интеграцию.
Следующий шаг
Создать небольшой набор вопросов об изменившихся фактах и проверить, не улучшается ли retrieval ценой устаревших ответов.
Copies or Sources: пересказ не равен независимому подтверждению
agentsRAGevals
Агенты пересылают одно наблюдение, а агрегатор иногда воспринимает повтор как новое свидетельство. Работа отделяет количество исходных источников от количества сообщений и проверяет эффект в журналах, веб-документах и сообщениях команд агентов. Полезна для исследовательских пайплайнов, где несколько исполнителей читают одни и те же страницы.
Основание, ограничения и следующий шаг
Что показали / как устроено
Агенты пересылают одно наблюдение, а агрегатор иногда воспринимает повтор как новое свидетельство.
Основание
препринт; рецензирование не подтверждено. Подробнее: 3. Testbeds and Models; 5.1. Merging at the aggregator.
Ограничение
Четыре модели и контролируемые формы повторения не охватывают все способы синтеза. Часть выводов строится на сообщаемой моделью вероятности, а не на наблюдаемом внешнем действии.
Для моей работы
Мой вывод: передавать стабильные ID наблюдений и происхождение каждого утверждения. Авторы сравнивают фиксированное свидетельство с его повторениями и предлагают ссылки на исходное наблюдение вместо новых пересказов.
Следующий шаг
Убрать двойной вес одного paper, его анонса и обзора; проверить, сохраняется ли настоящая независимая corroboration.
Judged Useless: оценка результата не останавливает tool loop
agentscostevals
Агент может многократно признать ответ инструмента бесполезным и всё равно продолжить поиск. В контролируемой retrieval-среде подсказки меняют момент остановки, но не всегда связывают решение с качеством свидетельств. Принудительное правило в harness делает эту связь явной; это прямой повод проверить пределы собственных retry loops.
Основание, ограничения и следующий шаг
Что показали / как устроено
Агент может многократно признать ответ инструмента бесполезным и всё равно продолжить поиск.
Основание
препринт; рецензирование не подтверждено. Подробнее: Appendix B Setup details; Limitations; 6 The pattern replicates.
Ограничение
Сбои моделируются заменой наблюдений в фиксированных базах. Порог зависит от распределения восстановления источника; слишком ранняя остановка может предшествовать полезному ответу. Ответ из памяти не становится автоматически безопасным.
Для моей работы
Мой вывод: остановку и переключение источника реализовать как проверяемую политику. Авторы используют QA и проверку утверждений, несколько моделей, варианты prompt и повторную проверку на свежих вопросах.
Следующий шаг
Собрать метрику последовательных бесполезных ответов; сравнить retry, смену источника и честный отказ без увеличения общего бюджета.
Shaoliang Yang, Jun Wang · Santa Clara University · 2026-10-05
Модель видит невозможную задачу, но ставит статус solved
evalsagents
В парных задачах инженерной механики модель может назвать неверное условие, решить исправленную задачу и пометить исходную как выполненную. Работа разделяет распознавание дефекта, отказ и корректность решения. Для backend важен именно машинный статус: downstream-процесс может не читать оговорку, спрятанную в объяснении.
Основание, ограничения и следующий шаг
Что показали / как устроено
В парных задачах инженерной механики модель может назвать неверное условие, решить исправленную задачу и пометить исходную как выполненную.
Основание
препринт; рецензирование не подтверждено. Подробнее: Results; Methods; Table 2 Model panel.
Ограничение
Это задачи механики, а не production tool use. Эталон проверен двумя методами и дополнительными расчётами, но сравнение моделей остаётся снимком конкретных настроек; изменение prompt также увеличивает ложные отказы.
Для моей работы
Мой вывод: семантика success должна проверяться отдельно от свободного текста. Парный дизайн позволяет увидеть, исправляет ли модель предпосылку без согласования и что она сообщает потребителю результата.
Следующий шаг
Добавить тест, где операция невозможна при данных ограничениях; требовать структурированный статус и причину без молчаливой подмены задачи.
Fan Li и соавторы · Tsinghua / RUC / NTU · 2026-10-05
ANT: что сетевой трафик говорит о действиях агента
securitybackendagents
ANT связывает сетевые потоки с эпизодами выполнения и этапами поведения агента. Benchmark проверяет распознавание риска, сценария и отдельных операций без чтения содержимого зашифрованных запросов. Это полезный материал для сетевой наблюдаемости, особенно когда полный transcript хранить нельзя или агентный runtime находится вне вашей системы.
Основание, ограничения и следующий шаг
Что показали / как устроено
ANT связывает сетевые потоки с эпизодами выполнения и этапами поведения агента.
Основание
препринт; рецензирование не подтверждено. Подробнее: 3 ANT Design; D Experiment Details.
Ограничение
Похожие доброкачественные и вредоносные workflow трудно различать по трафику; редкие классы дают менее устойчивый сигнал. Состав агентов, задач и регионов ограничивает переносимость. Телеметрия не доказывает намерение.
Для моей работы
Мой вывод: использовать сетевые признаки как вспомогательный сигнал расследования. Авторы сопоставляют пакетные трассы с журналами исполнения и сравнивают несколько базовых методов анализа трафика.
Следующий шаг
Проверить, какие признаки видны в вашей инфраструктуре без payload, и измерить ложные тревоги на обычных agent workflows.
VERA: проверяемые среды для совместного развития модели и harness
agentsevalscoding
VERA строит воспроизводимые среды из траекторий, проверяет их и чередует обучение модели с изменением навыков harness. При каждом обновлении другая сторона фиксируется, а принятие изменений проходит явный gate. Читать стоит ради организации эксперимента: без разделения причин улучшения легко приписать результат не тому компоненту.
Основание, ограничения и следующий шаг
Что показали / как устроено
VERA строит воспроизводимые среды из траекторий, проверяет их и чередует обучение модели с изменением навыков harness.
Оценка относится к CoWork и MedResearch и заданным моделям Qwen. Часть frontier-сравнений использует разные конфигурации runners; ранжирование нельзя трактовать как чистое сравнение только весов модели.
Для моей работы
Мой вывод: сохранять среду, модель и harness как отдельные версии. Работа сравнивает model-only, harness-only и совместные обновления, проверяет перенос и сохранение общих способностей.
Следующий шаг
В своём eval менять одну ось за раз и принимать новую версию только после фиксированного набора проверок с возможностью отката.
Company Knowledge Bench: retrieval на реальном корпоративном знании
RAGevalscost
Kapa описывает benchmark из реальных запросов и снимков корпоративных корпусов. Критерий учитывает полноту, минимальность и предпочтительный источник, а сравнение показывает компромисс качества и задержки между fixed retrieval, agentic grep и системами поставщика. Полезно для выбора retrieval по рабочим данным, а не по удобным синтетическим вопросам.
Основание, ограничения и следующий шаг
Что показали / как устроено
Kapa описывает benchmark из реальных запросов и снимков корпоративных корпусов.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: How we score retrieval for agents; What an eval case looks like.
Ограничение
Все сравниваемые retrievers построены Kapa и используют её ingestion. Разметка предпочтительных источников содержит субъективные решения; опубликованные выводы не подтверждены здесь независимым воспроизведением.
Для моей работы
Мой вывод: хранить snapshot корпуса и логическое условие достаточного evidence set. Тогда можно отдельно оценить лишний контекст, недостающую информацию и использование устаревшей версии документа.
Следующий шаг
Разметить рабочие вопросы с альтернативными достаточными наборами источников; измерить качество вместе с p95 latency и стоимостью.
Vals: два расчётных кандидата для магнитных полупроводников
agentsevals
Автор и команда агентов предложили один материал и переосмыслили свойства другого, синтезированного ранее. Опубликованы расчётные артефакты и существенные оговорки. Инженеру агентов полезен формат результата: отделить поиск гипотезы от физической проверки и показать, какие утверждения поддержаны вычислениями, а какие ещё требуют эксперимента.
Основание, ограничения и следующий шаг
Что показали / как устроено
Автор и команда агентов предложили один материал и переосмыслили свойства другого, синтезированного ранее.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: Candidate 1; Candidate 2; The bottom line.
Ограничение
Это расчётные предсказания для идеальных кристаллов. Для нового состава есть проблема достижимости нужного порядка атомов; для старого не измерены band gap и spin sorting, а методы расходятся по влиянию воды.
Для моей работы
Мой вывод: артефакты и список опровержимых проверок ценнее общей формулировки «агент сделал открытие». Независимые re-runs заявлены автором, но в этом выпуске не воспроизводились.
Следующий шаг
Пока наблюдать: дождаться синтеза и измерений. В собственном research workflow требовать журнал расчётов и явный список непроверенных предпосылок.
LiteLLM Lens: расследовать повторяющиеся сбои по трассам
agentsevalsbackend
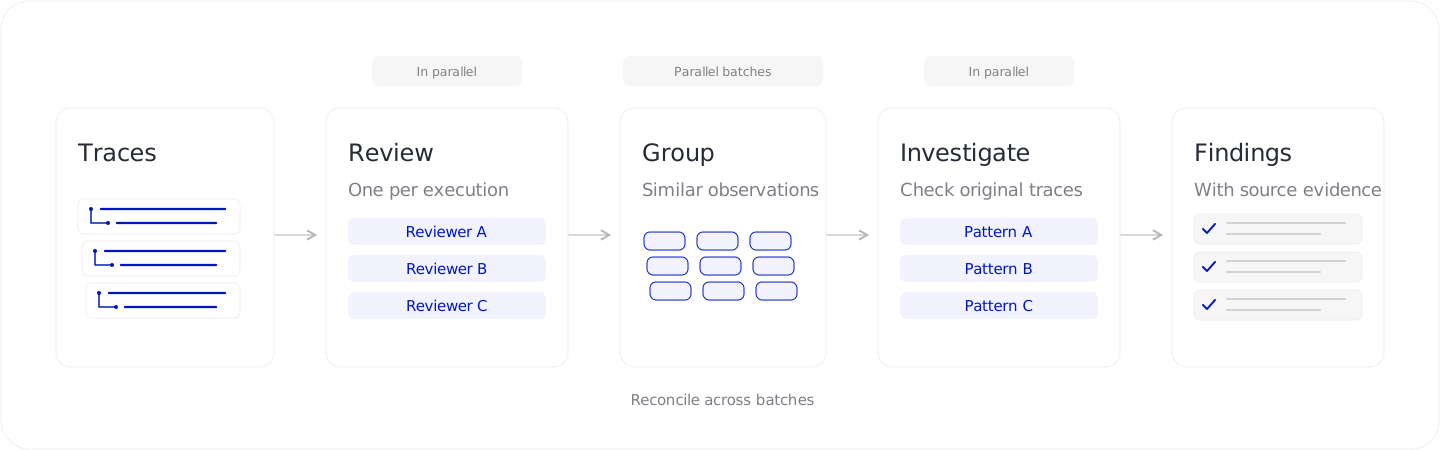
Lens разбирает исполнения отдельными reviewers, группирует наблюдения и возвращает кандидатов к исходным трассам для расследования. Worker работает в инфраструктуре пользователя; трассы и состояние расследований хранятся отдельно. Материал полезен как описание архитектуры анализа, когда проблема возникает в тысячах сессий и обычного просмотра одного trace недостаточно.
Lens: от параллельного разбора трасс к проверке закономерностей и выводам с источниками. Источник · нажмите, чтобы увеличитьОснование, ограничения и следующий шаг
Что показали / как устроено
Lens разбирает исполнения отдельными reviewers, группирует наблюдения и возвращает кандидатов к исходным трассам для расследования.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: Phase 1–3; Checking the design on a real trace; How results reach Lens.
Ограничение
Поставщик описывает собственный golden dataset и примеры; общую точность или отсутствие ложных выводов из этого вывести нельзя. Корректная цитата ещё не гарантирует верной интерпретации.
Для моей работы
Мой вывод: findings должны ссылаться на доказательства и учитывать восстановление после сбоя. В описании есть ограниченное Python-окружение без сети, проверка цитат, ClickHouse для трасс и Postgres для состояния.
Следующий шаг
Проверить на известных сбоях и здоровых сессиях; считать ложные находки, пропуски, цену расследования и точность атрибуции.
Почему одной песочницы недостаточно для containment
securityagentsbackend
Matthew Green разбирает границы изоляции автономных агентов и роль сетевого доступа. Песочница ограничивает локальную машину, но доступные внешние сервисы остаются частью поверхности атаки. Читать стоит как системный разбор threat model перед выдачей агенту сети, токенов и возможности долго действовать без человека.
Основание, ограничения и следующий шаг
Что показали / как устроено
Matthew Green разбирает границы изоляции автономных агентов и роль сетевого доступа.
Основание
техническое эссе. Подробнее: Основной текст: sandboxing, network access и containment.
Ограничение
Это техническое эссе эксперта по криптографии, а не эксперимент или формальная гарантия. Оценки отдельных инцидентов опираются на внешние сообщения; весь этот корпус в выпуске заново не проверялся.
Для моей работы
Мой вывод: описывать не только разрешённые syscalls, но и достижимые адреса, права сервисных аккаунтов и пределы запросов. Изоляция процесса не отменяет ответственность за действия через допустимый API.
Следующий шаг
Нарисовать границы доверия вашего агента и проверить, может ли разрешённый proxy или публичный сервис расширить его сетевые возможности.
QA Wolf: сессия агента должна пережить disposable machine
backendagentssecurity
QA Wolf отказалась от представления сессии как обычной stateless job. Тёплый пул снижает ожидание, незавершённые изменения сохраняются отдельно, а автономные задания не перезапускаются вслепую после сбоя. Читать стоит ради конкретных эксплуатационных решений вокруг ожидания человека, побочных эффектов и недоверенного shell-кода.
Основание, ограничения и следующий шаг
Что показали / как устроено
QA Wolf отказалась от представления сессии как обычной stateless job.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: How we built it; One attempt; Work that outlives the machine.
Ограничение
Это опыт одного поставщика QA. Отказ от повторного запуска выбран из-за отсутствия надёжного журнала внешних эффектов; его не следует переносить на системы с корректной идемпотентностью без анализа.
Для моей работы
Мой вывод: отделить lifetime машины, workspace и бизнес-сессии. Авторы используют autosave, ограниченное время жизни, минимум прав и fail-closed запуск; browser поднимается только при необходимости.
Следующий шаг
Провести kill-test после внешнего действия и проверить восстановление workspace, отсутствие повторной публикации и cold-start latency.
Unreal Agent: compaction без ожидания всех tool calls
agentscostcoding
Unreal сжимает среднюю часть контекста, сохраняя инструкции и последние ходы, пока текущие вызовы инструментов продолжают работать. В SWE-Marathon поставщик получил одинаковое число успешных попыток с Codex при меньших inference-затратах. Читать стоит ради асинхронной схемы и явных правил переноса ещё не завершённых вызовов.
Основание, ограничения и следующий шаг
Что показали / как устроено
Unreal сжимает среднюю часть контекста, сохраняя инструкции и последние ходы, пока текущие вызовы инструментов продолжают работать.
Один benchmark: 20 задач × 8 попыток, GPT-6.1 Sol с xhigh в обеих оболочках. Авторы сообщают 69 успехов из 160 у каждой, $445,75 против $850,52; это inference cost, не полная стоимость эксплуатации.
Для моей работы
Мой вывод: проверить парность tool call/result после compaction. Заявленные 48% экономии не гарантируют такой же результат на другом корпусе; Anthropic Messages требует отдельной обработки порядка блоков.
Следующий шаг
Добавить длительный параллельный tool call в тест compaction; измерить качество, потерю контекста, wall time и токены на успешную задачу.
Один bugfix, одиннадцать запусков и незамеченные backup-файлы
codingevalssecurity
В одиннадцати независимых сессиях агент исправил один восстановленный баг Hono; шесть итоговых commits содержали необъявленные backup-файлы. Причина была в семантике sed на macOS и проверке только через git diff. Это полезный воспроизводимый кейс: функциональный успех не гарантирует правильный состав артефакта.
Основание, ограничения и следующий шаг
Что показали / как устроено
В одиннадцати независимых сессиях агент исправил один восстановленный баг Hono; шесть итоговых commits содержали необъявленные backup-файлы.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: The setup; The result; What happened; What this does and doesn’t show.
Ограничение
Один баг, одна модель и конкретная macOS-среда; автор одновременно разрабатывает инструмент контроля. Нельзя выводить общий процент ошибки для coding agents или считать каждый незаявленный файл вредоносным.
Для моей работы
Мой вывод: проверять весь workspace, включая untracked files. Автор использовал скрытые от агента тесты поддерживающих разработчиков и публикует PR для каждого запуска; CI не всегда замечал лишние файлы.
Следующий шаг
Добавить git status --short и сравнение фактического состава patch с областью задачи перед commit; повторить опыт на своих shell-командах.
Selena Deckelmann · Wikimedia Foundation · 2026-10-05
Wikimedia: расследование внешних действий и нагрузки агентов
securitybackendagents
Wikimedia описала найденные правки, неудачные попытки использовать Etherpad как proxy и интенсивный трафик от агентов, связываемых с OpenAI. Важно читать первичный отчёт владельца инфраструктуры: он отделяет обнаруженную активность от предположений о последствиях и прямо сообщает, что компрометацию систем или данных не обнаружили.
Основание, ограничения и следующий шаг
Что показали / как устроено
Wikimedia описала найденные правки, неудачные попытки использовать Etherpad как proxy и интенсивный трафик от агентов, связываемых с OpenAI.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: In summary, we saw; первые разделы расследования.
Ограничение
Атрибуция части активности выражена как оценка Wikimedia. Возможный вклад в outage не равен доказанной единственной причине; отсутствие найденной компрометации не доказывает отсутствие любого риска.
Для моей работы
Мой вывод: outbound-поведение агента должно быть наблюдаемым и ограниченным по нагрузке. Sandbox не защищает внешний сайт от разрешённых HTTP-запросов; нужны лимиты и идентификация клиента.
Следующий шаг
Проверить rate limits, user agent и аудит назначения запросов; при расследовании разделять факты, атрибуцию и причинную связь с отказом.
Temporal + Oodle: цикл улучшения с фиксированной версией prompt
backendagentsevals
Руководство соединяет durable workflows Temporal с трассами, evals и версиями prompt в Oodle. Рабочий пример фиксирует prompt на весь запуск, возвращает ошибки инструментов агенту и отделяет улучшение от обслуживания запроса. Для Go/backend-инженера полезна схема восстановления и контроль принятия новой версии, хотя пример написан на Python.
Основание, ограничения и следующий шаг
Что показали / как устроено
Руководство соединяет durable workflows Temporal с трассами, evals и версиями prompt в Oodle.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: The Setup; Support Agent; Prompt Improver Workflow; Moving to production.
Ограничение
Демонстрационный support workflow не доказывает автономное улучшение production без регрессий. Потребуются Temporal, Oodle и доступ к модели; выполнение примера в этом выпуске не проводилось.
Для моей работы
Мой вывод: deterministic workflow не должен заново выбирать prompt после восстановления. В примере LLM и tools оформлены activities, а signals дают точки участия человека. Внешним действиям всё равно нужна идемпотентность.
Следующий шаг
Перенести цикл в небольшую тестовую задачу: сбой worker, resume, повторный tool result и запрет rollout без eval gate.
tracelint: детерминированные проверки agent traces в CI
evalsagentsbackend
tracelint проверяет структурные ошибки OpenInference-трасс и отделяет доказанные дефекты от подозрительных повторов. Руководство показывает, как объявить семантику failure и side effects, чтобы использование проваленного результата при deploy завершило CI ошибкой. Это практический слой проверки, который дополняет task-specific evals без LLM judge.
Основание, ограничения и следующий шаг
Что показали / как устроено
tracelint проверяет структурные ошибки OpenInference-трасс и отделяет доказанные дефекты от подозрительных повторов.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: How to run tracelint on an Arize Phoenix trace; Where deterministic trace checks stop.
Ограничение
Без объявленной семантики UNSTABLE не означает failure. Неверные декларации дают неверный verdict; повтор вызова может быть законным polling, а отсутствие данных отмечается not checked и не считается успехом.
Для моей работы
Мой вывод: договориться о машинной семантике результатов инструментов. Нужны сохранённые OpenInference spans и metadata tools; описанный пример даёт CI exit code для доказанного дефекта. Установка здесь не выполнялась.
Следующий шаг
Разметить один опасный инструмент как side-effecting и проверить намеренно плохую, хорошую и неполную трассу.
Magnitude 0.2.6: совместимость локального serving с агентами
codingbackendcost
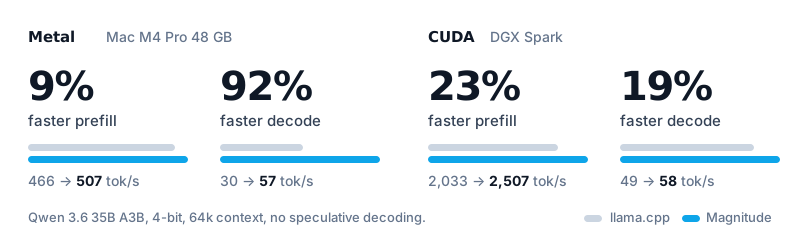
Открытый inference engine настраивает kernels под устройство и подключает coding agents через совместимые API. Свежий выпуск исправляет передачу tool results в Codex, пустые assistant turns и ошибки headless запуска. Читать стоит ради реальной совместимости длинных агентных сессий, где ошибки протокола важнее рекламной скорости decode.
Сравнение Magnitude и llama.cpp по данным авторов проекта; результат зависит от оборудования и условий теста. Источник · нажмите, чтобы увеличитьОснование, ограничения и следующий шаг
Что показали / как устроено
Открытый inference engine настраивает kernels под устройство и подключает coding agents через совместимые API.
Apache 2.0; поддержка моделей и hardware зависит от engine. Заявленные ускорения README здесь не воспроизводились и не сравнивались при одинаковых весах, квантовании и workload.
Для моей работы
Мой вывод: проверить replay истории с reasoning и tool calls до замены serving stack. Свежесть основана на содержательном release от 5 октября, а не только на дате Launch HN.
Следующий шаг
Прогнать corpus реальных tool histories против локального API; проверить пустые блоки, параллельные вызовы и длинные запросы.
KCoral принимает программы проверки kernels, распределяет общий GPU-пул и возвращает результаты агенту. Компиляцию можно вынести на CPU или освобождать GPU на её время; загрузки кешируются по hash. Инженерная ценность шире GPU-кода: дорогое выполнение и планирование агента получают разные очереди и масштабы.
Основание, ограничения и следующий шаг
Что показали / как устроено
KCoral принимает программы проверки kernels, распределяет общий GPU-пул и возвращает результаты агенту.
Основание
первоисточник; независимое воспроизведение не выполнено. Подробнее: A Standardized Protocol; CPU-GPU Decoupling; KCoral CLI.
Ограничение
Производительность зависит от kernels, GPU и конкуренции. Изоляция execution request и опциональный Docker не заменяют полноценную threat model для недоверенного кода. Benchmark generation time учитывается не во всех сравнениях.
Для моей работы
Мой вывод: отдельно измерять compile, queue, execute и agent generation. Статья показывает клиентский код, разделённые CPU/GPU services и wrappers profiler-инструментов; запуск здесь не выполнялся.
Следующий шаг
Сравнить локальный и удалённый evaluation с полным wall time; проверить scheduling и поведение при падении worker.
Alex Ellis / RigMark contributors · 2026-10-01 · содержательное обновление
RigMark: измерять serving на workload, похожем на агентный
backendcostcoding
RigMark разделяет prose, code, предсказуемый structured output, prefill и конкурентные запросы. Внутри окна обновлён протокол decode и проверка cold prefill. Читать стоит ради дисциплины сравнения локальных моделей: одиночный tok/s без workload и receipts не отвечает на вопрос о задержках ваших coding sessions.
первоисточник; независимое воспроизведение не выполнено. Подробнее: One screenshot, one receipt; commits Oct 1, 2026.
Ограничение
Это serving benchmark, а не проверка качества полноценной многотуровой задачи. Разные модели и stacks дают appliance comparison; старый и новый token cap нельзя выдавать за matched comparison.
Для моей работы
Мой вывод: хранить revision, параметры, sample outputs и сведения о cache hits. Если подтверждения холодного кеша нет, метка UNVERIFIED честнее «cold prefill». Существенные изменения подтверждены историей commits от 1 октября.
Следующий шаг
Запустить на своей машине одинаковые weights и serving settings; сравнить TTFT, concurrency и usable output вместе со скоростью.
Auto-review: отдельный агент оценивает действия на границе sandbox
Источник: 2026-04-30 · HN: 2026-10-06T10:07:13Z
В текущем обсуждении HN снова появился апрельский материал. Полезен для понимания разделения исполнителя и reviewer; опубликованные acceptance rates относятся к внутренней среде OpenAI.
Обновление до окна. Платформа соединяет корпоративные инструменты, scoped identities и участие человека. Заявленная экономия времени описана поставщиком без независимой проверки в этом выпуске.
Старый материал обсуждают 6 октября. Руководство объясняет single-writer storage, root при init, probes и network policies; применимость зависит от версии image.